Edição 00 (piloto)Janela 05/11 – 11/11/202614 itensFechada em 11/11
RAG
O que saiu de IA nesta semana, lido por quem faz comp: o que é, o que muda no trabalho e o que ainda é só promessa.
Capa
Imagem: Comfy Org / Lightricks
10/11comfy.orgconferido na fonte
O LTX ganhou um pacote de finishing
A Comfy Org e a Lightricks juntaram quatro fluxos do LTX para footage que já existe. Nada aqui gera plano novo: é reenquadrar, tirar alpha, levar para HDR e subir resolução.
ReframeReenquadra o clipe num canvas novo. Roda por nó de API.
AlphaGenAlpha com transparência parcial e borda fina, até 4K. Pesos abertos e LoRA.
SDR → HDRSaída em ACEScct com primárias AP1. A LoRA anterior trabalhava em ARRI LogC3 com Rec.709. O template usa nó de API; há pesos abertos e LoRA.
UpscaleSobe para 4K ou 8K. Pesos abertos e LoRA; o workflow de exemplo parte de 1080p.
Pra compÉ o primeiro pacote do LTX pensado para acabamento. O HDR em ACEScct/AP1 entra num pipeline ACES sem a volta por LogC3. A página não cita EXR em lugar nenhum, então o formato de saída ainda precisa ser visto no template.
Um checkpoint só para texto→imagem, geração por referência e edição. Gera perto de 16 MP (4096×4096, ou 6272×2688 em 21:9), em 6 passos fixos, com até 16 imagens de referência. A licença é a comunitária da MiniMax; não li os termos de uso comercial.
No repack do ComfyUI o modelo de difusão vem em 12,5 GB (w4a8), 21 GB (int8) ou 40 GB (bf16). O text encoder pesa 15,7 ou 27,1 GB.
Pra compMatte e elemento em 16 MP direto, com várias referências, sem passe de upscale depois. Numa 3090 o w4a8 cabe na VRAM, mas o text encoder vai disputar memória. Não testei.
Gemini Omni 1.2 Flash: 15 segundos e edição por conversa
O clipe nativo vai de 3 a 15 s (o 1.1 parava em 10). Dá para corrigir em vários turnos de conversa e passar referência de personagem, produto, estilo, um clipe de movimento de até 3 s e áudio. O rascunho sai em 360p ou 720p e os melhores sobem para 1080p ou 4K.
Custa US$ 0,07 por segundo em 720p, 30% menos que a versão anterior.
Pra compCorrigir por conversa evita regenerar o plano inteiro por causa de um detalhe. Tudo que sai leva a marca d'água invisível SynthID.
Entram no core o H3-Image, o RelayVSR e o WeVisOne-VL. O Qwen 3.x passa a aceitar vídeo de entrada e chega o rebake de textura com UltraTex. Nos partner nodes: Seedance 2.5 em 4K, Seedream 5.5, Kling 4.0 Flash e o Omni Flash 1.2.
Pra compA mudança mais útil é discreta: a fatia de VAE do SeedVR2 agora se ajusta à memória livre, o que deve cortar estouro de VRAM no upscale.
05/11 repack · 10/11 no corehuggingface.coconferido na fonte
RelayVSR: upscale de vídeo 2× e 4×, Apache-2.0
Upscaler de vídeo que a Comfy Org reempacotou para rodar nativo, com modelos int8 para 2× e 4× e um workflow de exemplo em 2×. O modelo original é o kopper/RelayVSR.
Pra compUpscale dentro do próprio grafo e com licença livre. Falta comparar com o que já está em uso antes de trocar qualquer coisa.
Regenerate-2K-IC: draft de 768p vira 2K sem trocar o rosto
Refinador aberto da NVlabs para o MiniMax H3. O draft de 1344×768 fica no contexto do transformer e o clipe em 1080p, 2K ou 4K nasce ao lado dele em três chamadas. Por isso rosto, lip sync, texto e layout seguem o draft.
A LoRA oficial tem 8,3 GB. O Kijai publicou uma versão de cerca de 200 MB, e os quatro nodes do ComfyUI são do slmonker, não oficiais. A página não cita licença.
Pra compGerar barato em 768p e refinar só o que foi aprovado. É onde o upscale comum costuma quebrar rosto e letreiro.
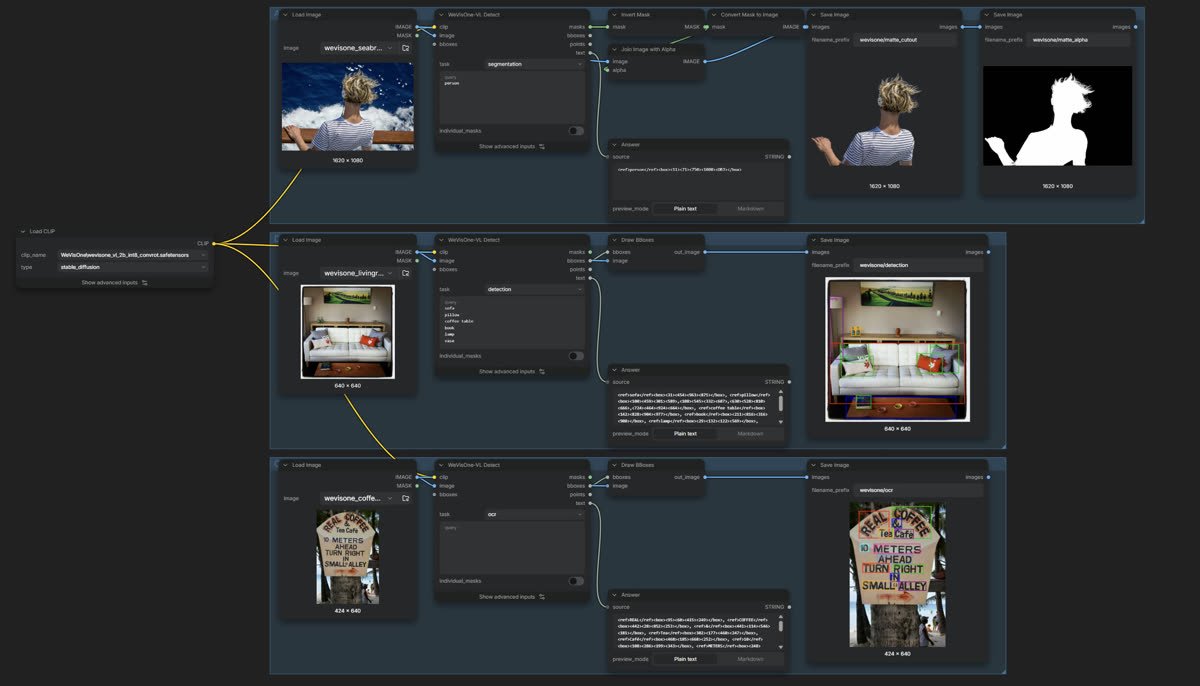
Node nativo que recebe uma imagem e uma frase e devolve caixas, máscaras por instância, alpha matte, pontos, contagem ou caixas de OCR. Os checkpoints vão de 2,9 a 9,7 GB.
Os limites estão escritos no artigo: só aceita imagem única, então não é tracker, e a borda fina deriva em oclusão pesada e em objeto transparente.
Pra compServe para máscara rápida num frame, sem SAM nem backend separado. Para sequência ainda precisa de tracker por cima.
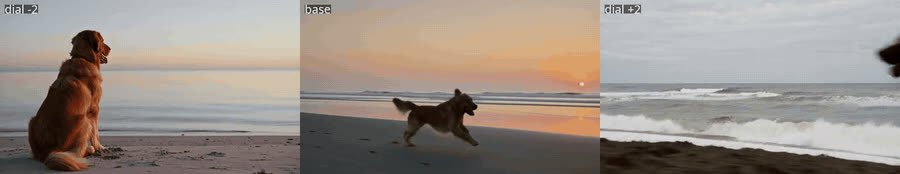
Um par de prompts vira um arquivo de 14 KB que funciona como dial de −2 a +2 no MiniMax H3. No dial de movimento, +2 dá 2,7 vezes o movimento base e −2 derruba para 0,05 vezes, quase parado. Não precisa de treino, referência nem passe extra. O autor trata como experimental.
Pra compQuantidade de movimento é o que o prompt sozinho não controla direito. Vale testar em placa viva, onde a diferença entre brisa e vendaval decide o plano.
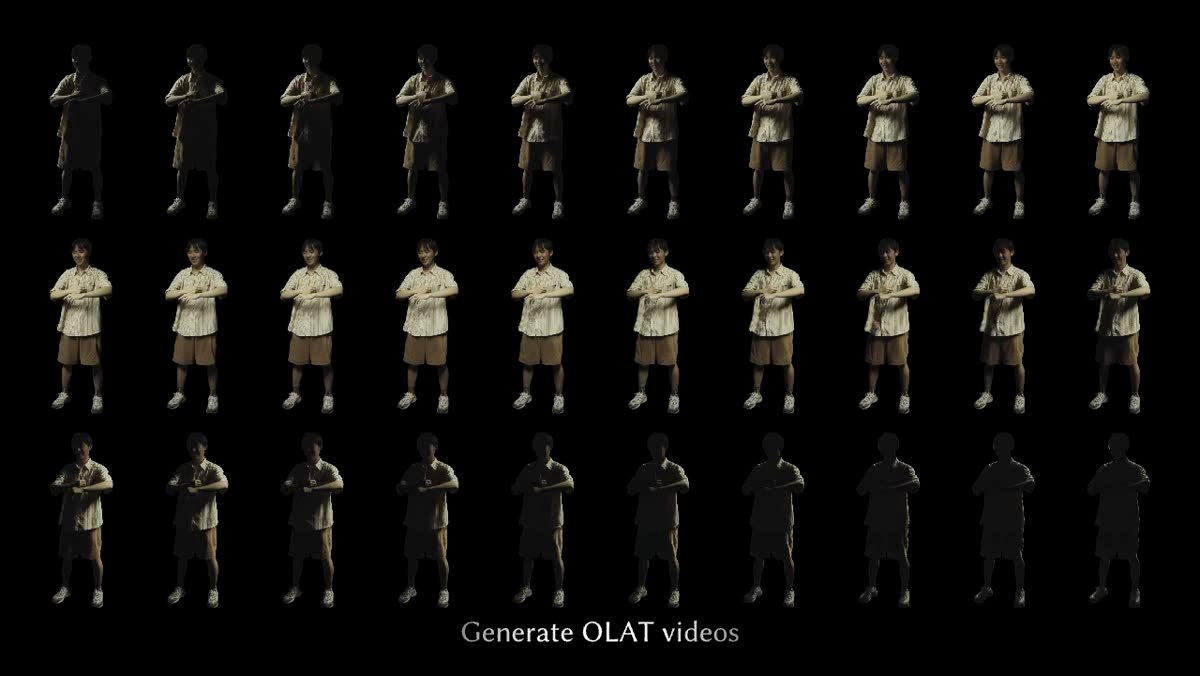
A partir de um vídeo com luz chapada, o modelo prevê os vídeos OLAT (uma luz acesa por vez) e depois os combina conforme o environment map. Aceito no SIGGRAPH Asia 2026, com um dataset de mais de 24 milhões de frames.
Pra compÉ relight com direção de luz explícita, do jeito que um light stage entrega. Por enquanto é só paper: o dataset e as ferramentas foram prometidos e não há código no ar.
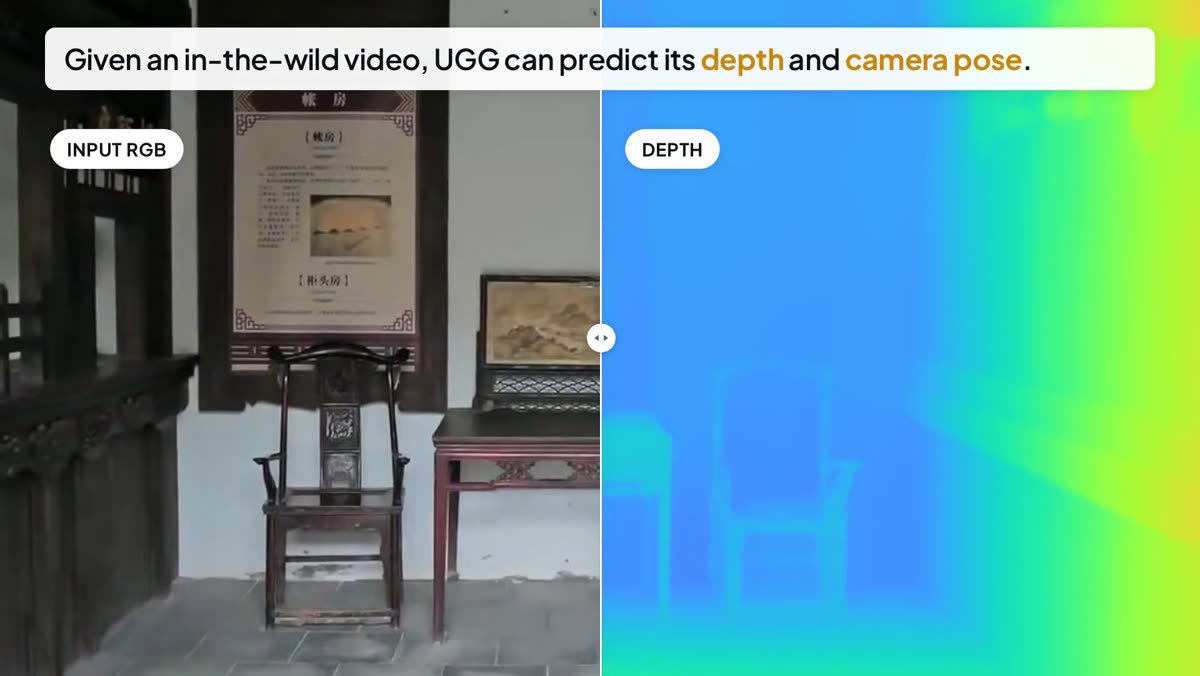
Um modelo generativo que trata vídeo RGB, profundidade e pose de câmera juntos. Gera vídeo com câmera controlada e também tira depth e câmera de um vídeo comum. Aceito no NeurIPS 2026.
Pra compDepth e câmera saindo junto do RGB é o que projeção e set extension pedem. A página do projeto anuncia código; não conferi se já roda.
Munira Alkharraz trocou o cenário de um comercial filmado
Um comercial de banco rodado em Riade com câmeras ARRI e mais de 50 pessoas no set. Munira, da UNTAGD, substituiu os ambientes ao redor dos atores reais e manteve atuação e movimento de câmera. Usou Nano Banana para o ambiente de referência e Seedance para o vídeo, em cerca de cinco dias e 30 mil créditos.
Pra compÉ o job híbrido que está aparecendo em publicidade: live-action com ambiente por IA. A fonte é o blog da própria Higgsfield, então é material de divulgação. O banco não é nomeado e eu não assisti ao reel.
Still, Ryan: 1.500 prompts para uma cena, depois retoque à mão
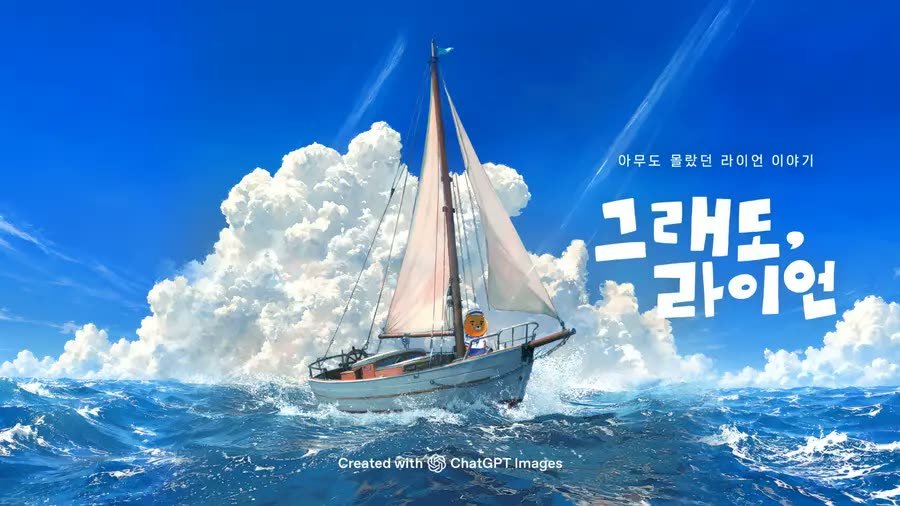
Curta de animação de cerca de cinco minutos da Kakao com a OpenAI, dirigido por Han Ji-won (Lost in Starlight). As imagens-base saíram do ChatGPT Images a partir de esboços. Uma única cena pediu perto de 1.500 prompts, e animadores retocaram tudo à mão para tirar o aspecto artificial.
Pra compO número que interessa é o do retrabalho. Com estúdio grande e parceria direta com a OpenAI, o acabamento ainda foi manual.
Gods Don't Give Gifts vai para o cinema em 4 de dezembro
Antologia de ficção científica de Zack London, o Gossip Goblin do YouTube, coproduzida por Edward Saatchi, da Fable. A meta é abrir em cerca de mil salas nos Estados Unidos. A voz e a aparência da Grimes estão no filme. London fala em uma equipe de umas duas dezenas de pessoas e meses de trabalho.
Pra compÉ o teste de bilheteria do longa feito com IA. As ferramentas não foram divulgadas. A matéria da Variety sobre o filme está atrás de paywall e eu não abri.
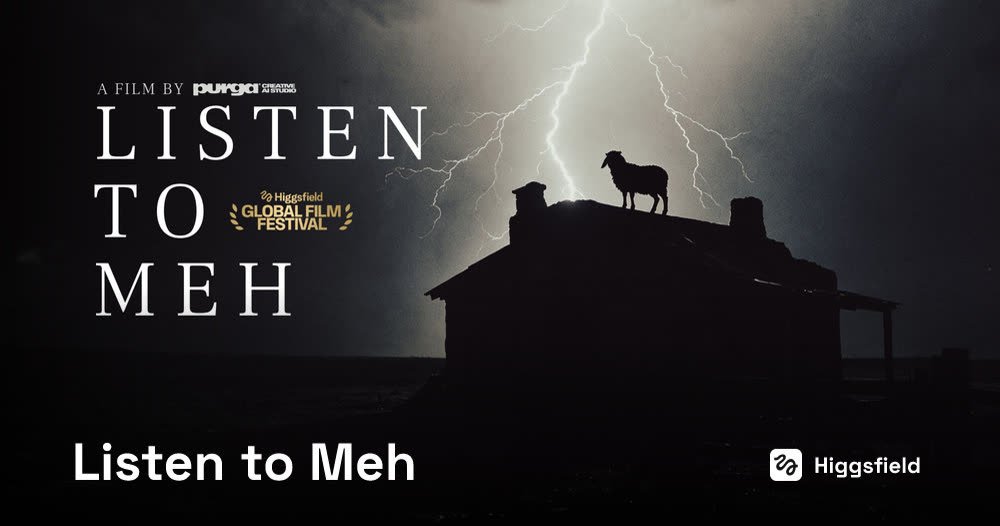
O primeiro curta de ficção da PURGA Studio venceu o Higgsfield Global Film Festival entre 67.223 projetos de 176 países. A história acompanha um gaúcho e uma ovelha que insiste em voltar para o telhado da casa dele. Assinam Martín e Manuel Montes de Oca, Bautista Vidal e Joaquín Iraola.
Pra compA notícia é de 02/11, três dias antes da janela. Entra mesmo assim por ser um estúdio daqui do lado ganhando o prêmio principal.
Três hipóteses que saem desta edição. Nenhuma foi testada.
O SDR→HDR novo do LTX em ACEScct/AP1 contra o HDR por IC-LoRA que já roda no Modal, no mesmo plano. Olhar highlights e banding.
O Regenerate-2K-IC num draft de pessoas em H3 a 768p. A identidade segura quando sobe para 2K?
O dial de movimento do H3 entre 0,05× e 0,3× numa placa viva. Dá brisa sem mexer o que é rígido?
Buracos desta edição
O Reddit bloqueou a coleta, então faltam os posts mais votados de r/comfyui, r/StableDiffusion e r/aivideo.
YouTube e Vimeo não abriram para a coleta. Não há tutorial nem Staff Pick aqui.
X e Instagram ficaram de fora porque pedem login. É onde a maioria dos artistas publica, e por isso a seção Gente saiu apoiada em imprensa e em blog de plataforma.
Banodoco não foi consultado.
Segundo a coleta, não houve lançamento na janela de Black Forest Labs, Lightricks (modelo base), Runway, Luma, Stability nem de áudio. Isso eu não conferi.