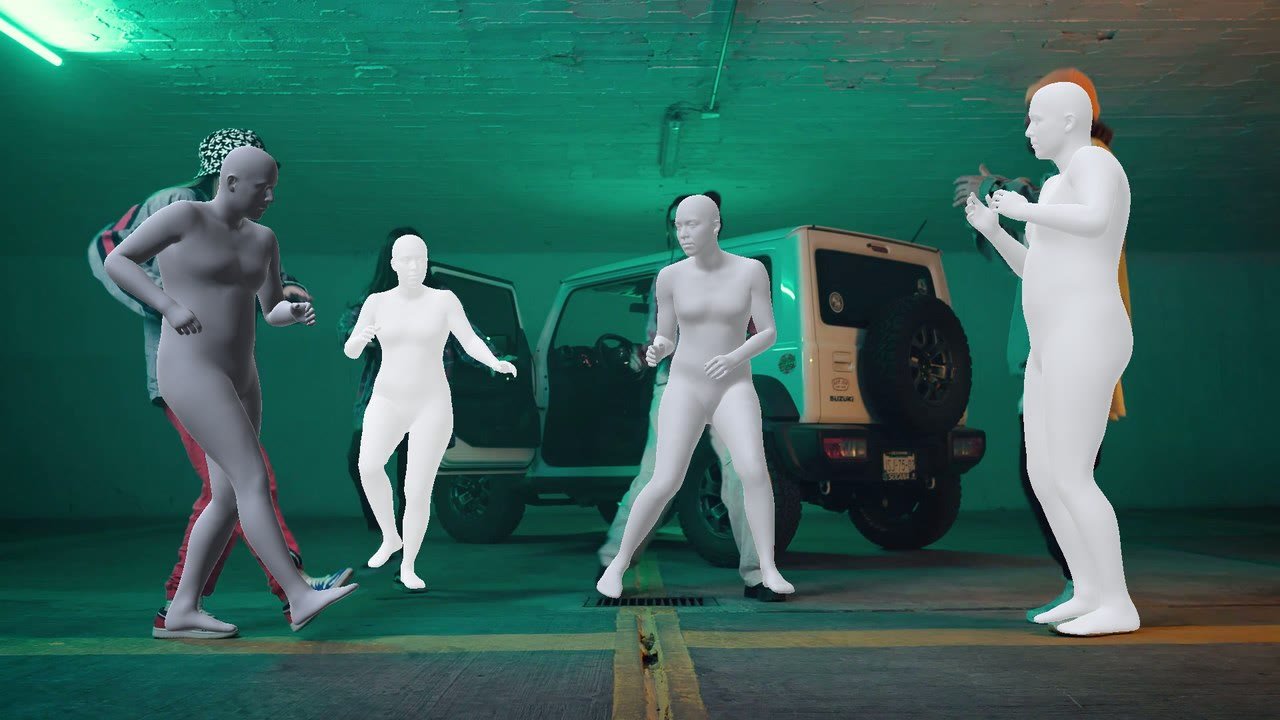Edição 01Janela 07/11 – 13/11/202620 itensFechada em 13/11
RAG
O que saiu de IA nesta semana, lido por quem faz comp: o que é, o que muda no trabalho e o que ainda é só promessa.
Capa
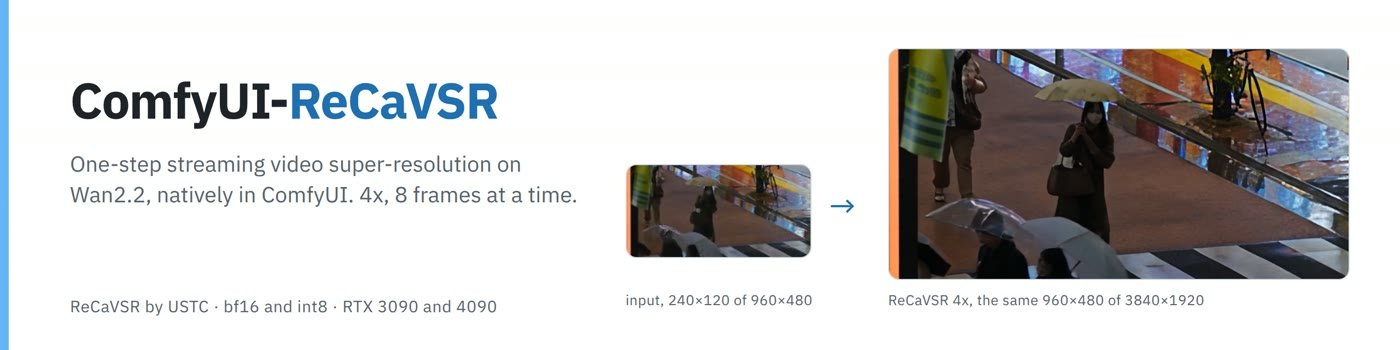
Imagem: PedroMarinhoDev / ComfyUI-ReCaVSR
10/11 repo · 11/11 no Banodocogithub.comconferido na fonte
ReCaVSR: 4K de vídeo numa 3090, em um passo
Upscaler de vídeo da USTC sobre o Wan2.2 TI2V-5B, portado para nodes nativos do ComfyUI. Faz 2× ou 4× com um único passo de difusão por bloco de 8 frames. Um decoder próprio vai soltando cada bloco, então clipe mais longo custa tempo, não memória.
Velocidade149 frames de 960×480 para 3840×1920: 36 s numa 4090 e 67 s numa 3090, com os pesos int8.
Clipe longo3:58 (7.153 frames) de 1080p para 4K em uns 25 min numa 4090, segundo o autor.
MemóriaSaída de 1440×1440 roda em placa de 8 GB. Em 24 GB vai até perto de 5,5K.
LicençaNodes GPL-3.0; o código portado do modelo segue Apache-2.0.
Pra compÉ o candidato direto a fazer o upscale de placa viva na própria máquina, sem Modal. O autor avisa que é upscale por difusão: o detalhe fino é gerado, não recuperado. Comparar com o RelayVSR da edição 00 no mesmo plano antes de trocar.
A versão nova do modelo de imagem da ByteDance sai com canal alpha nativo, com transparência total e parcial. A outra promessa é edição em até 100 rodadas seguidas sem estragar o que não foi pedido. Só por API e parceiros; já está nos partner nodes do ComfyUI.
Pra compElemento já recortado direto do gerador, sem passe de BiRefNet. O teste que importa é borda de cabelo e fumaça, onde o alpha parcial costuma falhar.
FlashRelight: tira a luz e põe outra, a partir de um HDRI
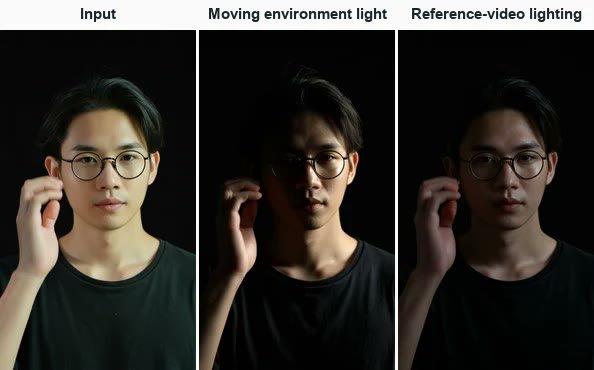
Relight de vídeo de retrato em duas etapas sobre o Wan2.1 1.3B. A primeira (FlashDelight) apaga a luz original; a segunda aplica luz de um environment map HDR, de um vídeo de referência ou de texto. Os pesos processam 49 frames em 480×832, com dois checkpoints de cerca de 7 GB cada. O model card não declara licença.
Pra compO delight sozinho já serve: tirar a luz chapada de um elemento gerado antes de iluminar no Nuke. A resolução é baixa para entrega; é ferramenta de teste e referência.
Memory-V2V: a mesma cena por câmeras novas, sem esquecer as anteriores
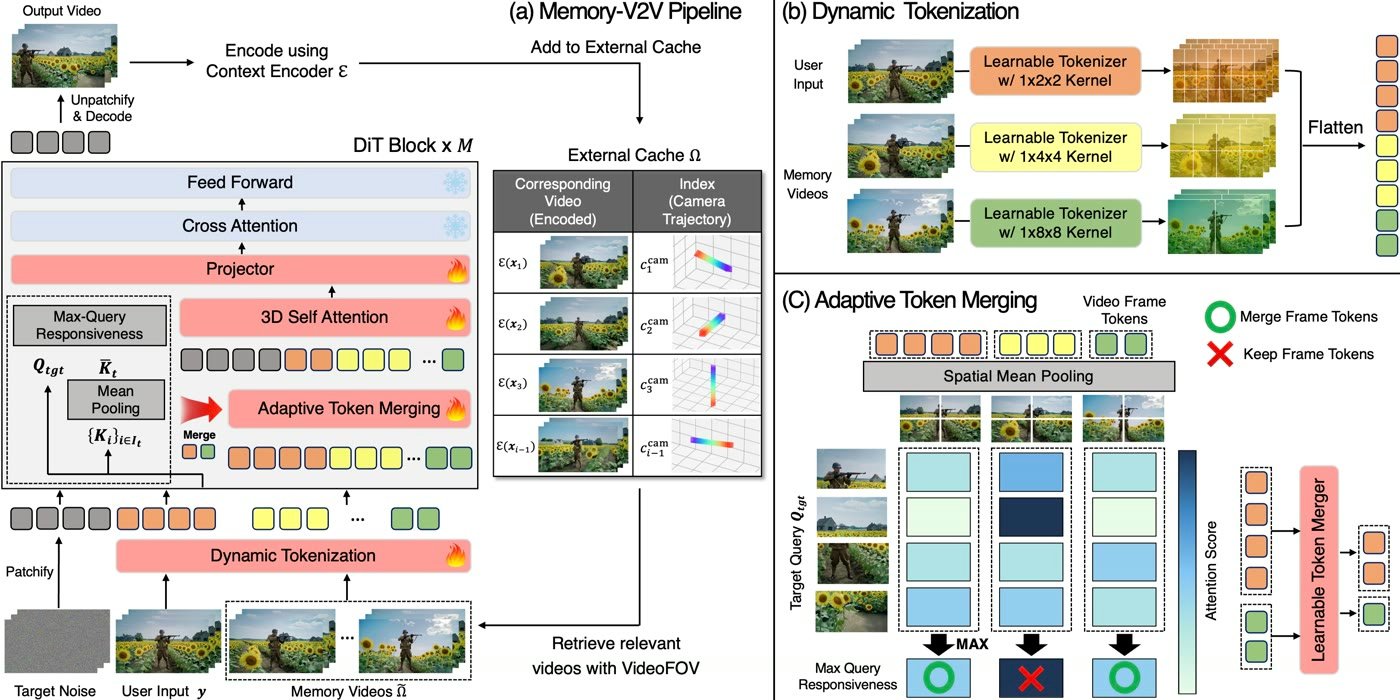
Da Adobe Research com a KAIST. Re-renderiza um vídeo por trajetórias de câmera novas, uma depois da outra, e cada vista nova lembra o que as anteriores mostraram. Sai em 81 frames a 832×480, sobre ReCamMaster e Wan2.1 1.3B. Pesos Apache-2.0; o modo de edição por texto do paper não veio junto.
Pra compMexe no problema de sempre da câmera gerada: a segunda tomada não bate com a primeira. Em 480p é para previs e estudo de câmera, não para placa.
Zonos3-Mini: voz clonada em 43 línguas, Apache-2.0
TTS aberto da Zyphra com clonagem de voz sem treino, 44,1 kHz e até 10 minutos por geração. São 800M de parâmetros, cerca de 100M ativos, e roda até no navegador.
Pra compFora do comp, mas no caminho da série: voz temporária para animatic e pitch, com licença que permite uso comercial. Português não foi testado.
PhotoDeblur: tira motion blur em tiles, na resolução original
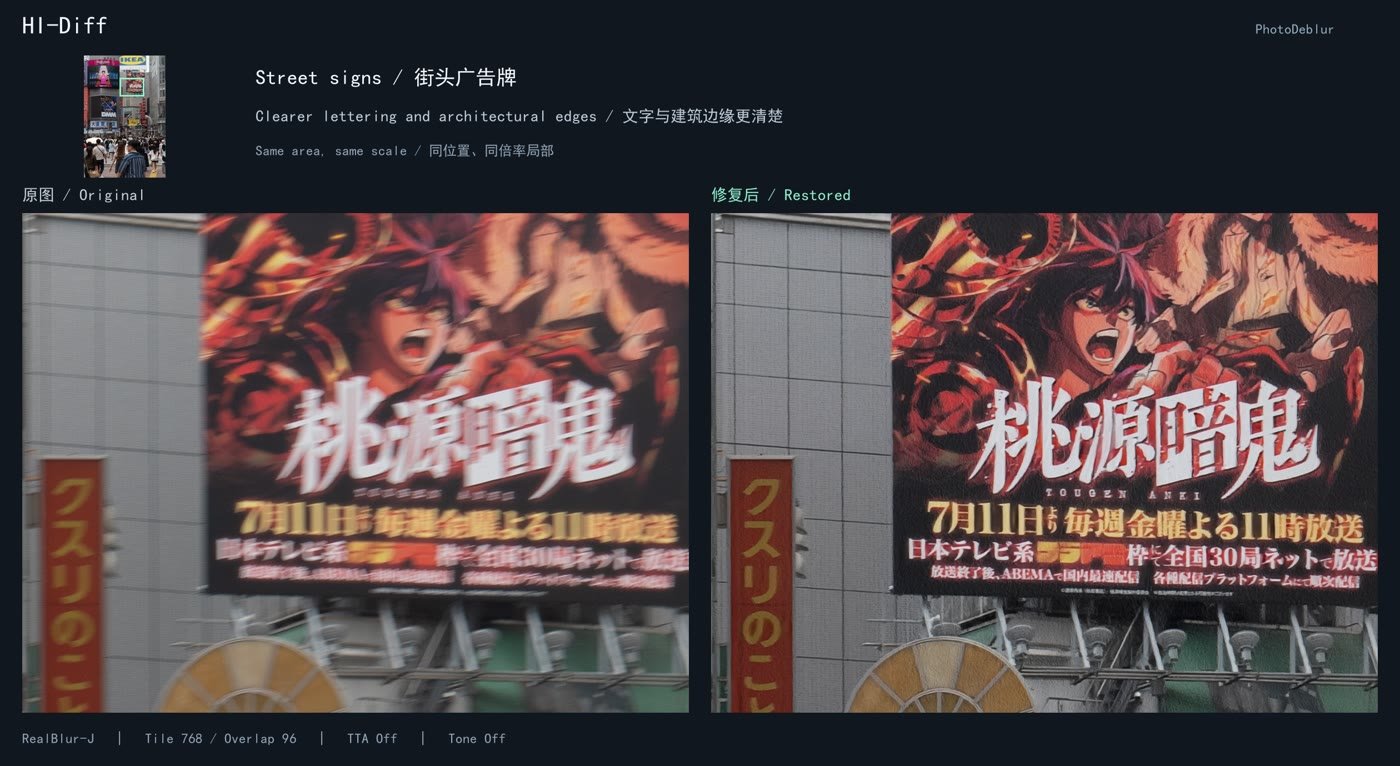
Nodes nativos para dois modelos de deblur, HI-Diff e MISCFilter, com processamento em tiles na resolução cheia, mistura nas emendas e TTA opcional. Código MIT; fez 90 estrelas na primeira semana.
Pra compÚtil em still e em frame de referência tremido: recuperar letreiro e aresta antes de projetar ou pintar em cima. É por imagem; em sequência vai piscar.
Cinco workflows de matte, cada um com tempo medido
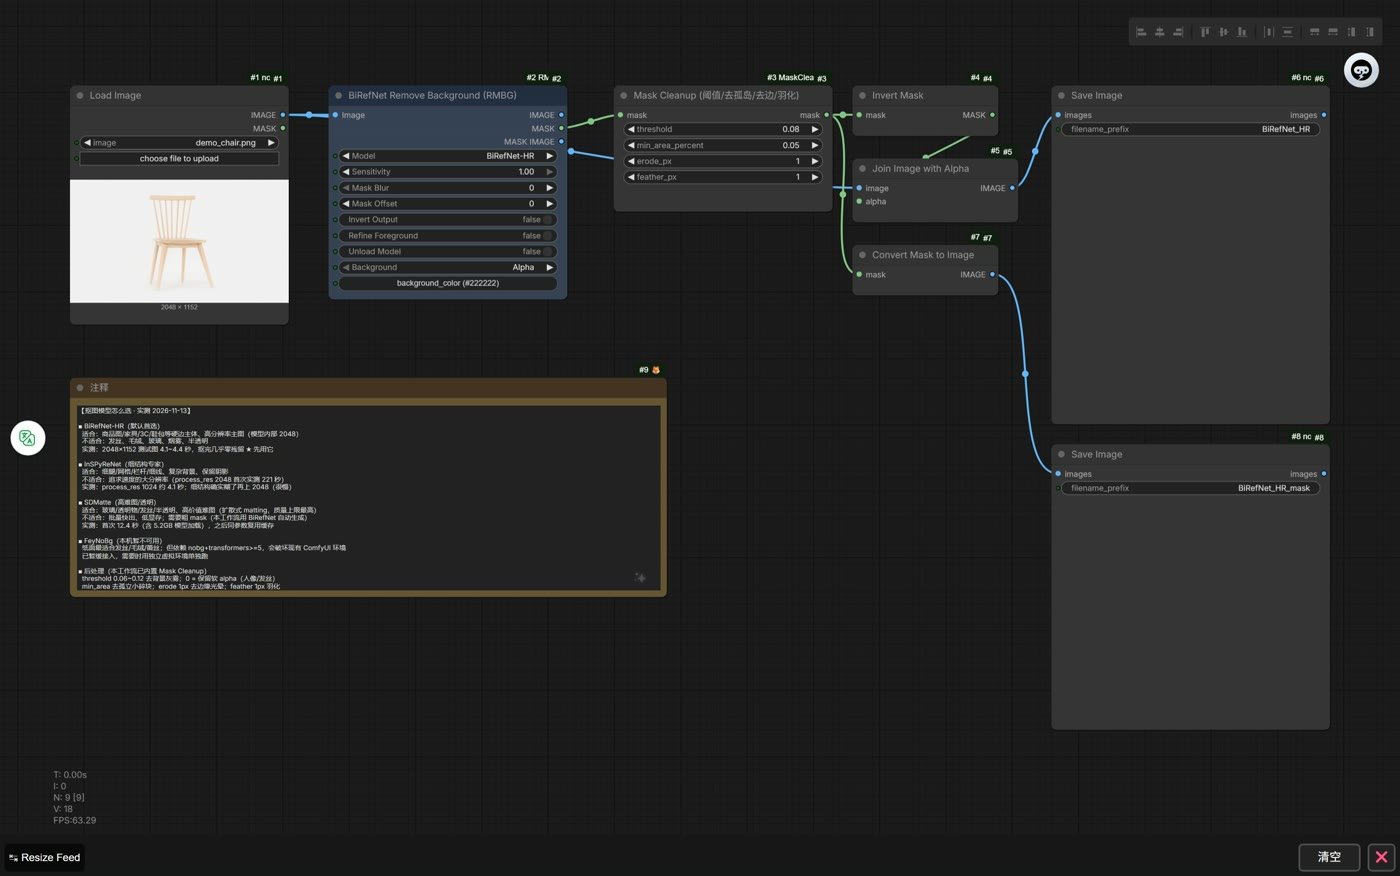
Um pacote com Lucida (vidro e texto), BiRefNet-HR (borda dura), Sapiens2 (retrato), InSPyReNet e SDMatte (cabelo e transparência), todos com o mesmo bloco de limpeza de máscara. O README dá o tempo de cada um. Repositório novo, sem licença declarada.
Pra compVale mais como tabela do que como download: diz qual modelo usar para qual borda. Os tempos são do autor e eu não conferi.
07/11 repo · 08/11 artigogithub.comconferido na fonte
InstantHMR: corpo 3D de foto, vídeo ou webcam
Nodes que ajustam um corpo 3D completo a partir de imagem, vídeo ou webcam em tempo real, sobre o SAM 3D Body nativo do ComfyUI. Transmite o movimento por VMC e dirige personagem rigado. Código Apache-2.0; a licença dos pesos eu não conferi.
Pra compReferência de corpo para posicionar sombra e contato de gente composta, e mocap barato para a série. Não é matchmove de câmera.
Troca o decoder VAE do Wan2.1 14B por uma cabeça convolucional e gera cada frame direto em pixel. Chega a 1664×960 com a mesma quantidade de tokens que o modelo usa em 480p. A página do projeto aponta para código e pesos; não conferi se estão no ar.
Pra compMuito do mingau de textura em vídeo gerado vem do VAE. Se isso vingar, sobra menos para limpar no upscale.
Da CMU. Usa correspondência entre pedaços do vídeo de entrada para buscar o que já foi gerado e manter a cena igual quando a câmera volta. Base VACE 1.3B, em tempo real. Sem código por enquanto.
Pra compÉ o defeito que mata restyle de plano longo: a câmera volta e o cenário mudou. Por enquanto só paper.
Neural Render Proxies: relight interativo de cena renderizada
Uma rede pequena treinada por cena aprende o transporte de luz a partir de um passe que não depende da luz, e reilumina a 30–60 Hz. Funciona com renderizador de produção que não é diferenciável. Aceito no EGSR 2026. Sem código.
Pra compÉ a promessa de mexer na luz do CG depois do render sem voltar ao 3D, que hoje se faz na mão com light groups.
Kosmo-GFM: câmera, depth e pontos 3D num modelo só
Modelo de geometria que tira parâmetros de câmera, profundidade, correspondências e pontos 3D dinâmicos, e recupera poses para Gaussian Splatting 3D e 4D. Os autores dizem que fazem em cerca de 20% do tempo de um pipeline tradicional. Não achei código.
Pra compSolve de câmera e depth do mesmo vídeo de IA, o passo que hoje trava matte com paralaxe. Só paper.
Framestore faz figurino andar sozinho com comp e IA
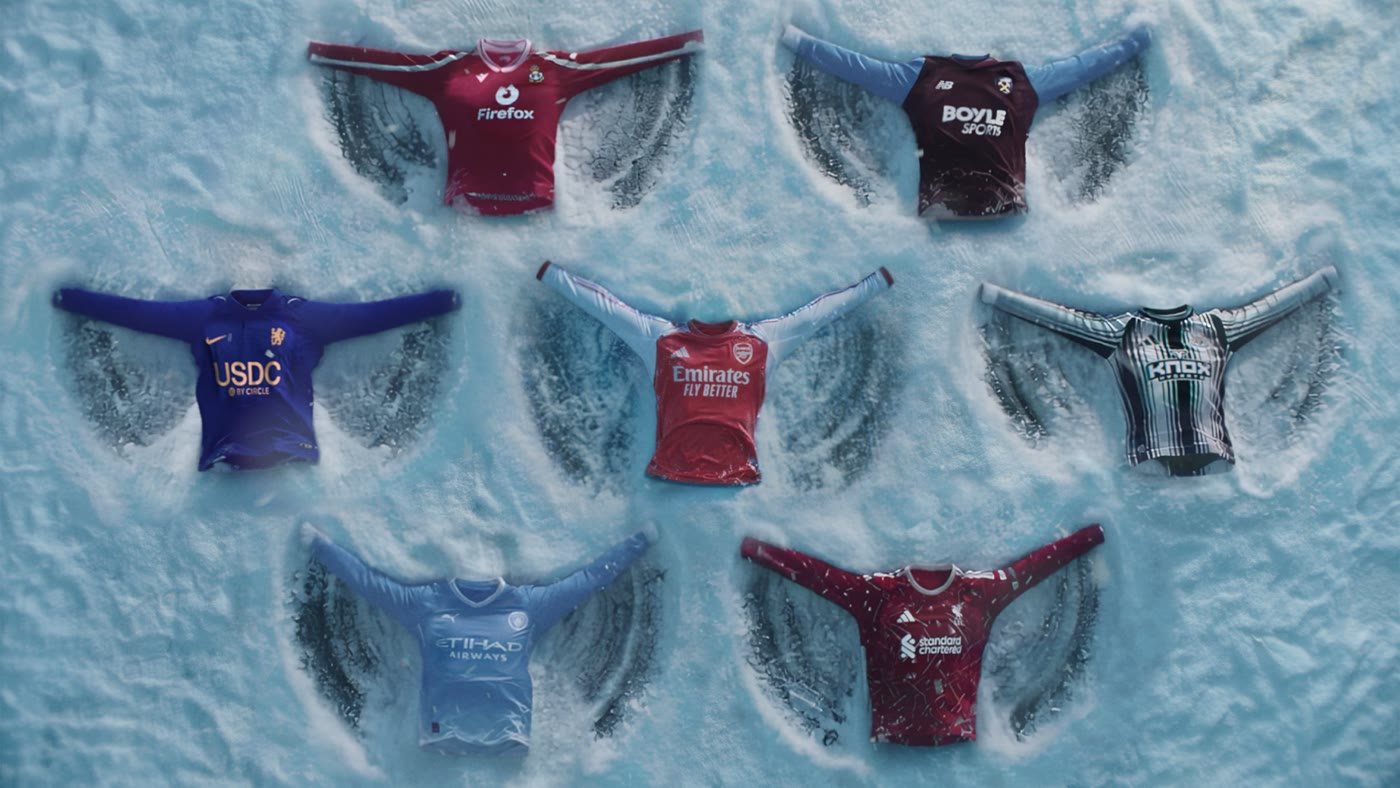
No comercial de Natal da Sky, a Framestore montou um pipeline de remoção de personagem que junta composição tradicional e IA para os figurinos parecerem se mover sozinhos. A IA também entrou no previs, para testar câmera, timing e lente antes de construir os armazéns em 3D. Os modelos não foram nomeados.
Pra compUm estúdio grande dizendo em público que remoção é comp com IA dentro. É o tipo de job que você já faz.
Carol Delgado, diretora, e Alberto Lopes, que passou mais de 30 anos na Vetor Zero, lançaram a ECHO. Já atendia Baygon, Vivo e OLX em silêncio; um dos trabalhos é a campanha de Halloween da Baygon, da Ogilvy Brasil. Carol leva o curta The Kitchen Tapes, premiado em festivais de IA.
Pra compVeterano de pós abrindo produtora de IA mostra para onde vai o orçamento de publicidade daqui. Possível cliente ou parceiro.
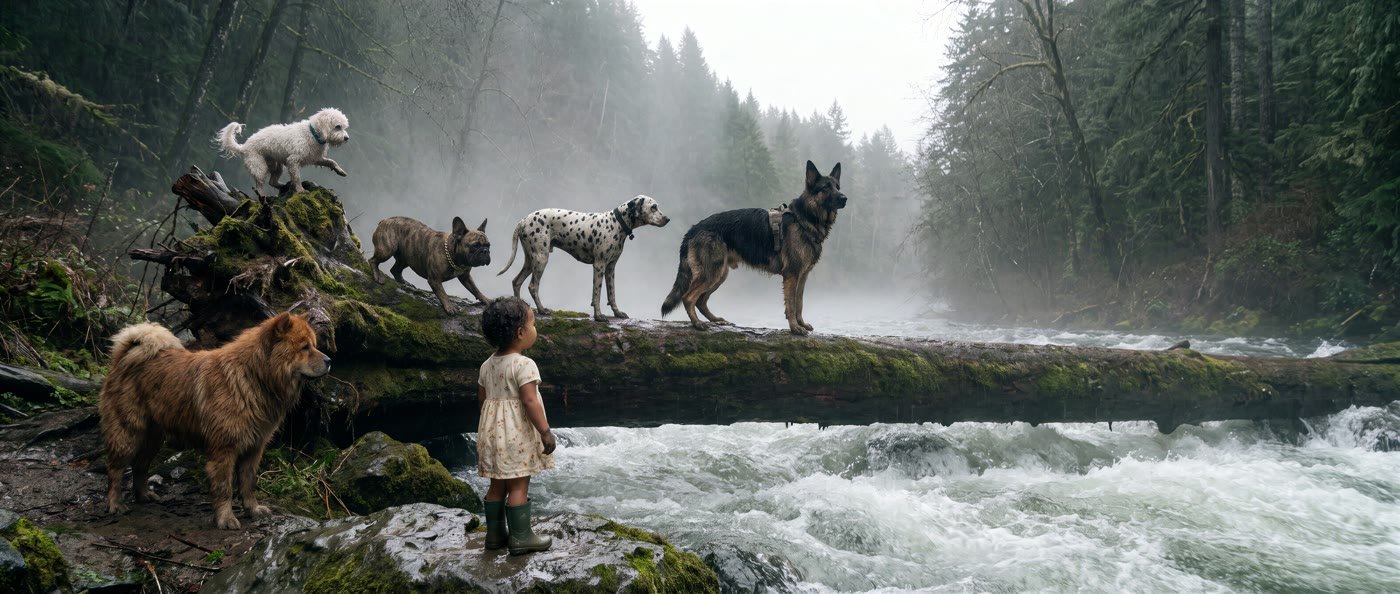
Storm Dogs: Rob Minkoff dirige longa com cães de IA
Eline van der Velden, da Particle 6 (a mesma da atriz sintética Tilly Norwood), produz um longa híbrido sobre cães que ajudam uma criança perdida. A criança e os cães são de IA, com dubladores humanos; algumas cenas são live-action. A equipe usa modelos existentes e Blender, e estima cerca de um ano até terminar.
Pra compO codiretor de O Rei Leão topou IA num longa. Híbrido de live-action com personagem gerado é onde comp entra.
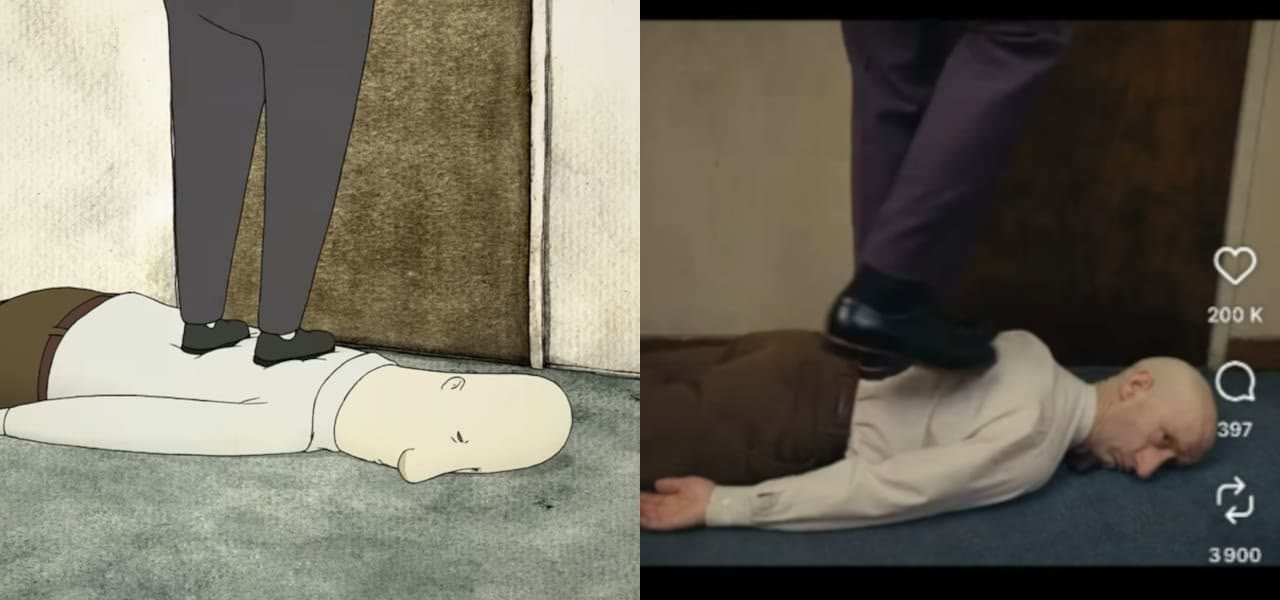
Uma conta do Instagram refez sem autorização o curta argentino El Empleo, de Patricio Plaza e Santiago Bou Grasso, para vender aulas de cinema com IA. O vídeo viralizou e foi removido depois da reclamação de Plaza. Os números de views vieram da coleta e eu não conferi.
Pra compO risco do outro lado: refazer obra conhecida queima a reputação de quem usa IA. Vale lembrar antes de qualquer peça de divulgação.
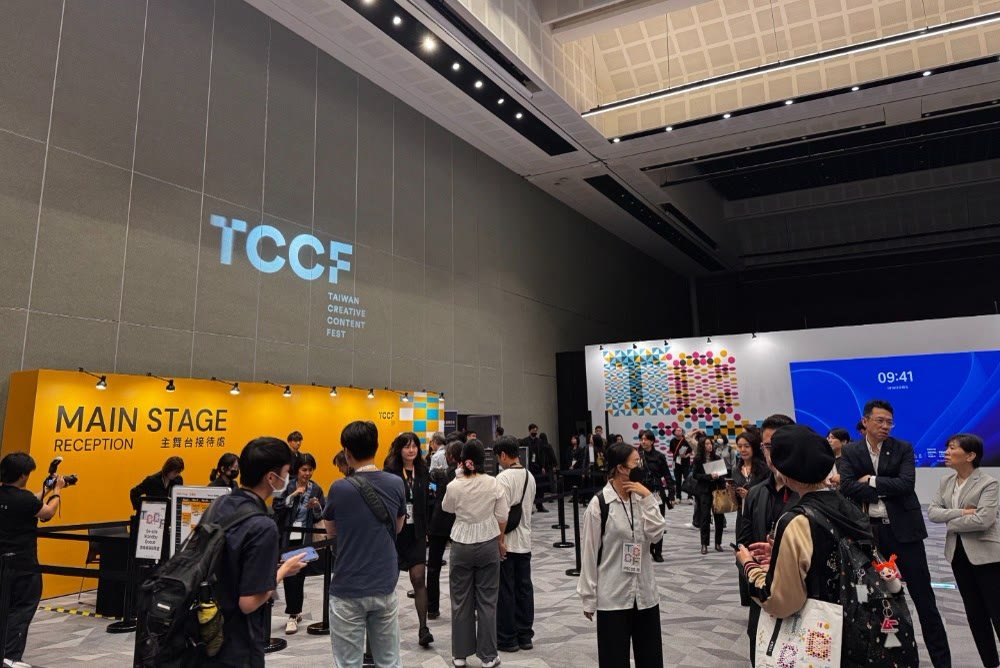
A Weta fechou parceria com a Moonshine Studio e vai montar uma plataforma de tecnologia para projetos de cinema e TV de Taiwan. Segundo a Weta, os jurídicos dos estúdios vetavam IA generativa no começo de 2025; na virada do ano, os clientes já perguntavam pela estratégia de IA dela, querendo saber quanto dava para economizar.
Pra compÉ o cliente que pergunta agora. Ter um pipeline com IA explicado em uma página passa a pesar na concorrência.
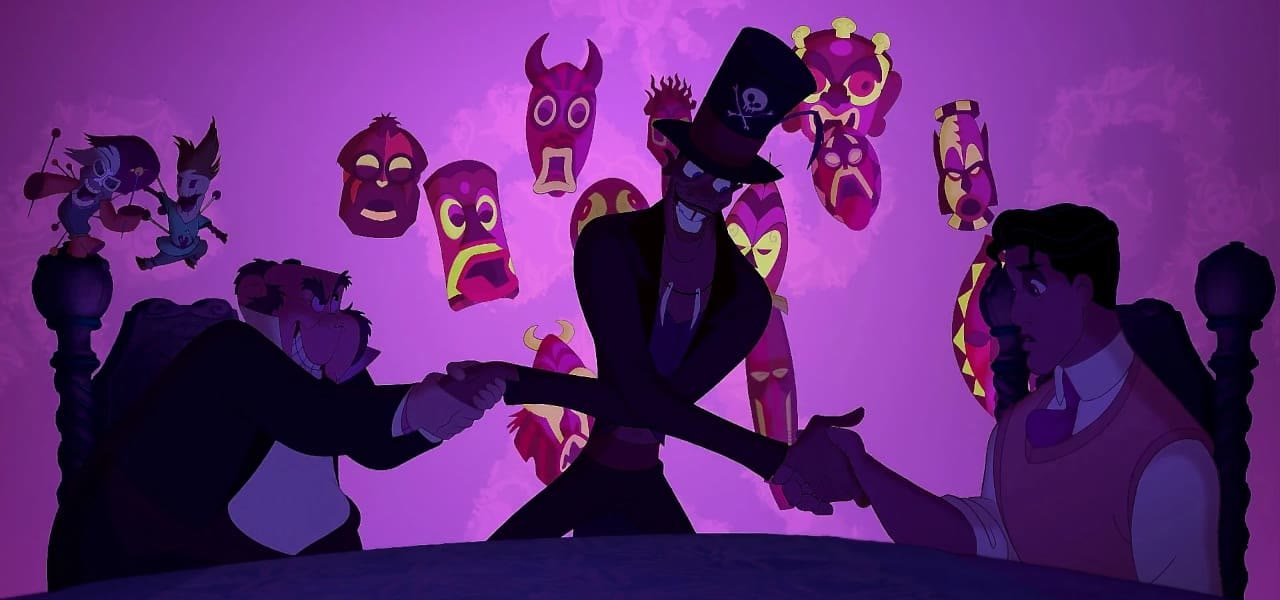
Acordo de vários anos para a Adobe treinar modelos sob medida com o acervo da Disney, voltados a saída "comercialmente segura e pronta para produção". A Imagineering já usa o Firefly Foundry para transformar desenhos em concept art. Valores não divulgados.
Pra compGrande estúdio quer modelo próprio, treinado no próprio acervo. É o caminho da franquia com IA: o modelo como ativo.
O festival de fotografia de cinema na Polônia aceita tecnologia nova, mas não filme totalmente gerado por IA. A edição deste ano tem painéis sobre IA e homenageia Darren Aronofsky, que usa a tecnologia.
Pra compA linha que os festivais estão traçando é híbrido sim, gerado do zero não. Conta na hora de escolher onde inscrever os curtas da série.
SAG-AFTRA: ator quer o vídeo fora do ar, não indenização
Duncan Crabtree-Ireland, CEO do sindicato, disse no Web Summit que a maioria dos atores com imagem ou voz usada por IA quer remoção, não processo. Ele defendeu o No Fakes Act, que obrigaria plataformas a tirar o conteúdo.
Pra compRosto de gente real em plano gerado continua sendo o maior risco de entrega. Personagem original não tem esse problema.
Três hipóteses que saem desta edição. Nenhuma foi testada.
ReCaVSR contra RelayVSR e o SeedVR2 do Modal, no mesmo plano de placa viva, de 1080p para 4K na 3090. Olhar folhagem e água, onde o detalhe inventado aparece.
Seedream 5.5 em RGBA num elemento com cabelo ou fumaça, contra BiRefNet num PNG comum. A borda parcial segura?
FlashDelight num elemento de pessoa gerado, antes de iluminar no Nuke. Sai uma base mais neutra que o original?
Buracos desta edição
Reddit, X e Instagram seguem fora: pedem login ou bloqueiam a coleta.
O Banodoco entrou, mas só pelos posts com mais reações em quatro canais. Houve conversa sobre um vídeo do Flux 3 e o lançamento do ComfyDevs, que não confirmei.
Magnific, Topaz, Adobe Firefly, Kling e o blog do Wan não abriram para a coleta. Pode ter lançamento deles que não aparece aqui.
Segundo a coleta, nada relevante de 3D na janela, e Google, OpenAI, Runway, Luma, LTX, Stability e BFL não lançaram modelo novo. Isso eu não conferi.
A janela encosta na da edição 00 (07 a 11/11 se repetem), mas nenhum item foi repetido.