Edição 02Janela 14/11 – 16/11/202618 itensFechada em 16/11
RAG
O que saiu de IA nesta semana, lido por quem faz comp: o que é, o que muda no trabalho e o que ainda é só promessa.
Capa
Imagem: vyrekai, exemplo do repositório dos workflows
14/11 repo · 15/11 atualizadohuggingface.coconferido na fonte
H3-Image: os 16 MP agora saem numa placa de 8 GB
O MiniMax H3-Image saiu com pesos abertos na edição 00. O que mudou: em 14/11 o vyrekai publicou três workflows de ComfyUI, para 8, 12 e 16 GB de VRAM, que entregam os mesmos 16 MP (3552×4736 em 3:4, 5472×3072 em 16:9) com os arquivos completos, sem GGUF. O ComfyUI passa o modelo pela placa em partes. O autor mediu pico de 3,7 GB de VRAM numa imagem de 16 MP e diz que, com a mesma seed, as três versões dão a mesma imagem pixel a pixel. A conta vai para a RAM do sistema: 24 GB no mínimo, 32 por segurança.
Os tempos são do autor, numa RTX 5070 Ti com a VRAM ocupada de propósito por outro programa, não em placas reais de 8 e 12 GB. Uma resposta no X relata falta de memória numa RTX 4070 de 12 GB. Eu não testei. Na versão de 8 GB o upsampler de prompt vem desligado e o decode do VAE é em tiles. No embalo, o benjiyaya abriu em 15/11 o LayoutKit, um canvas de caixas que monta o prompt de layout do H3-Image, ainda marcado como em desenvolvimento.
VRAMpico medido de 3,7 GB em 16 MP; RAM do sistema de 24 GB para cima
Tempo16 MP em 60 a 66 s, 6 passos (RTX 5070 Ti); 228 s com 4 imagens de referência em 8 GB
Arquivosmodelo 21 GB, text encoder 15,7 GB, VAE 1,2 GB; uns 38 GB de SSD
LicençaApache-2.0, só nodes nativos do ComfyUI
Pra compStill de base para matte em 16 MP, sem quantização, cabe com folga numa 3090: o limite passa a ser RAM e disco. Se usar a versão de 8 ou 12 GB, procure costura do decode em tiles em céu e parede lisa; na de 16 GB o decode é normal.
Robin: voz por descrição, e a sua própria fala com outro timbre
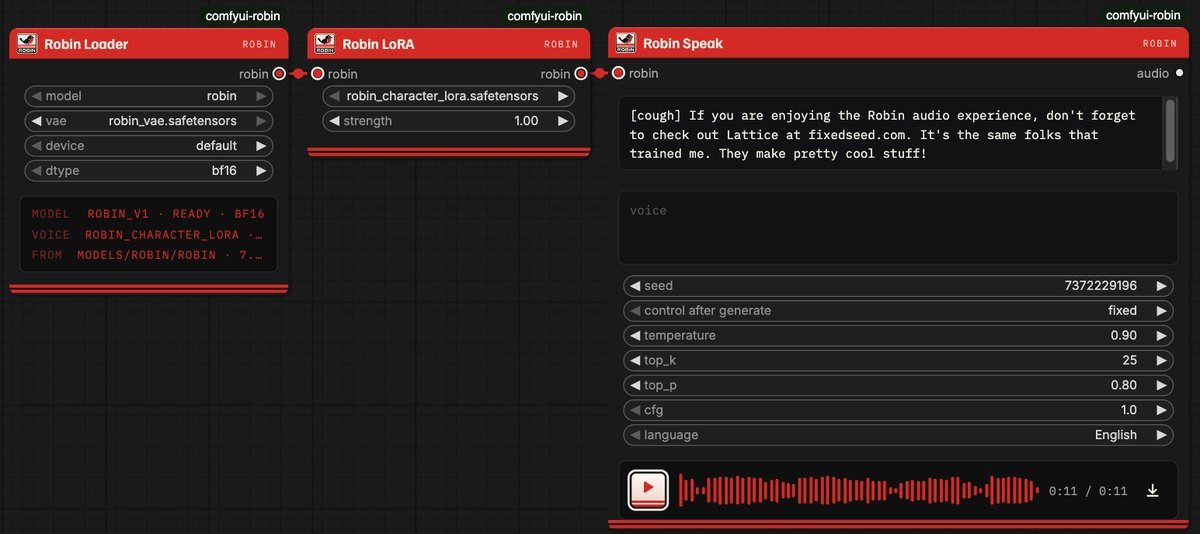
A Fixed Seed abriu os pesos do Robin, modelo de fala de 3,58 bilhões de parâmetros em 48 kHz. Faz três coisas: desenha uma voz a partir de um texto, refaz uma gravação sua com outra voz mantendo palavras, tempo e entonação (até 45 s) e treina LoRA de voz com 15 minutos de fala. Só inglês e japonês, sem português. O pico de GPU fica entre 8,2 e 9,9 GB em bf16, segundo o repositório, que já traz nodes de ComfyUI. A licença é própria, baseada na Apache, e limita o uso comercial acima de US$ 2 milhões de receita em 12 meses.
Pra compPara voz guia de animatic e personagem de teste em inglês, cabe numa 3090 junto com o resto. O modo que interessa é o de refazer a tomada: você atua a fala e troca só o timbre. Leia a licença antes de usar em trabalho pago.
Imagem: kijai / Comfy-Org, PR 17755, via comfyui-wiki
15/11github.comconferido na fonte
PAN 2 entra nativo no ComfyUI: vídeo de até 20 s, Apache-2.0
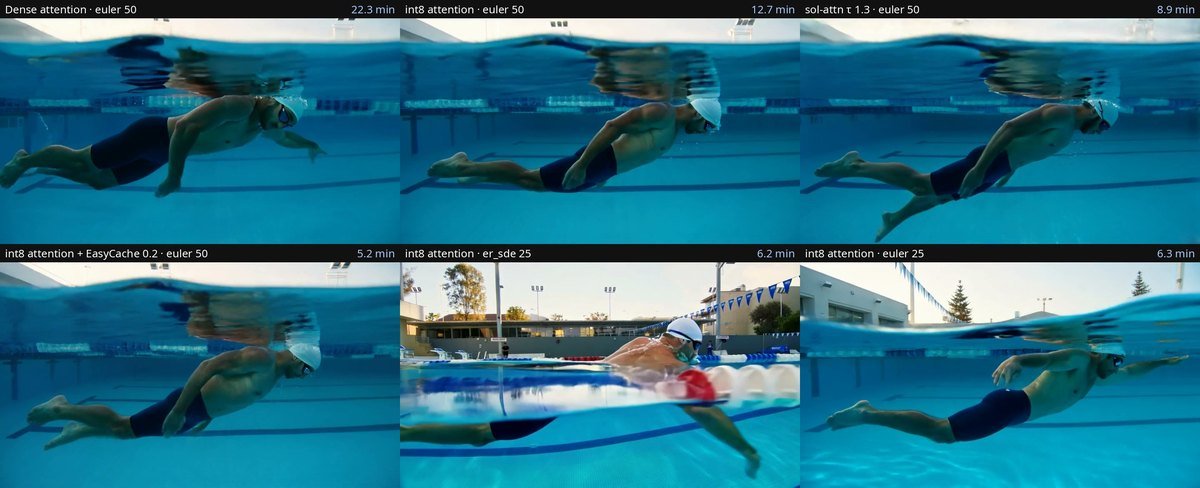
O PAN 2, modelo de mundo de 29 bilhões de parâmetros do MBZUAI, tem pesos abertos desde 07/10. O fato novo é o suporte nativo no ComfyUI, escrito pelo kijai e aceito em 15/11, com os arquivos da Comfy-Org no mesmo dia: text-to-video e image-to-video de até 20 s. A versão int8 pesa 26,7 GB (a bf16, 67,4 GB) e, numa RTX 5090, faz 241 quadros de 2880×1172 a 15,2 s por passo, contra 26,8 s da densa. O padrão são 50 passos. Só existe em build mais novo que a v0.45.0, ainda sem template oficial, e o prompt tem de ser uma legenda estruturada em JSON: frase solta devolve ruído.
Pra comp26,7 GB não cabem inteiros nos 24 GB de uma 3090, então depende de offload, e não achei medida em 3090. A 50 passos, um plano de 10 s leva uns 13 minutos na 5090. Fica para quando sair release com template; por ora é para quem roda o master.
Seedance 2.5 Flash chega ao ComfyUI: mais barato, só até 720p
O ComfyUI anunciou na noite de 15/11 o Seedance 2.5 Flash nos Partner Nodes: texto, primeiro e último quadro, múltiplas referências, edição e extensão de vídeo de referência, de 4 a 30 s em 720p com áudio nativo. Pelo anúncio, ele supera o Seedance 2.0 e custa menos que o 2.5. Os números abaixo vêm da imprensa (Startup Fortune, 15/11) e eu não conferi na BytePlus: API aberta em 15/11, cerca de US$ 0,15 por segundo em 720p, uns 34% abaixo do 2.5, sem 1080p nem 4K, e 20 arquivos de referência em vez de 50.
Pra compServe para o que hoje sai caro: variações de movimento e testes de first e last frame antes de gastar no modelo cheio. Como para em 720p, o plano aprovado ainda passa por upscale, e é nesse passo que a textura do matte se salva ou se perde.
14/11 PR · 15/11 aceitogithub.comconferido na fonte
Video Deflicker: node nativo para tirar o pisca de upscale quadro a quadro
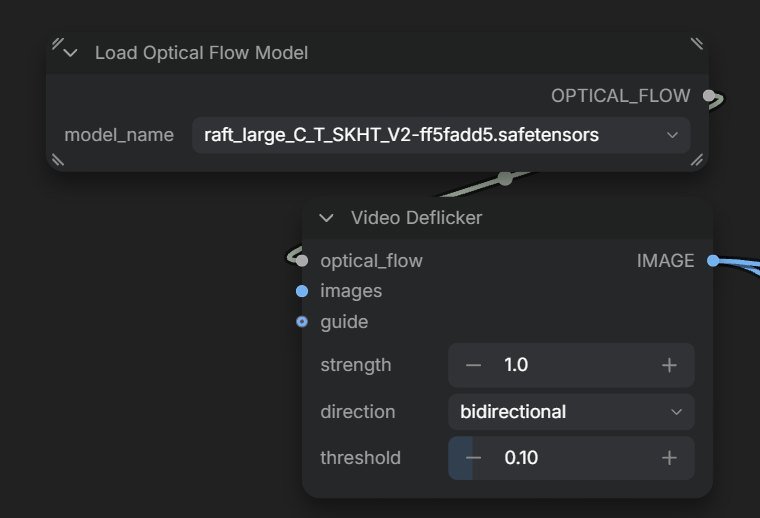
O kijai pôs no núcleo do ComfyUI o node Video Deflicker e um RAFT nativo de optical flow. O node recebe um vídeo processado quadro a quadro, como um upscale por frame, e devolve a consistência temporal: calcula o fluxo, deforma o quadro anterior já corrigido e resolve a mistura na GPU, com base no método de Bonneel e colegas (2015). Os controles são força, direção (só para a frente ou nos dois sentidos) e limiar, e há uma entrada opcional de vídeo guia para o fluxo. O RAFT nativo roda umas 2,3 vezes mais rápido que o do torchvision em 1024×576, segundo o PR. Só no master, depois da v0.45.0.
Pra compÉ o remendo para upscale e limpeza feitos frame a frame em placa viva. Com o plate original ligado como guia, o movimento vem dele e só o pisca deveria sair. Olhe borda fina, fogo e folha, onde o flow costuma errar e arrastar.
DiffHDR no ComfyUI: vídeo de 8 bits vira sequência EXR linear
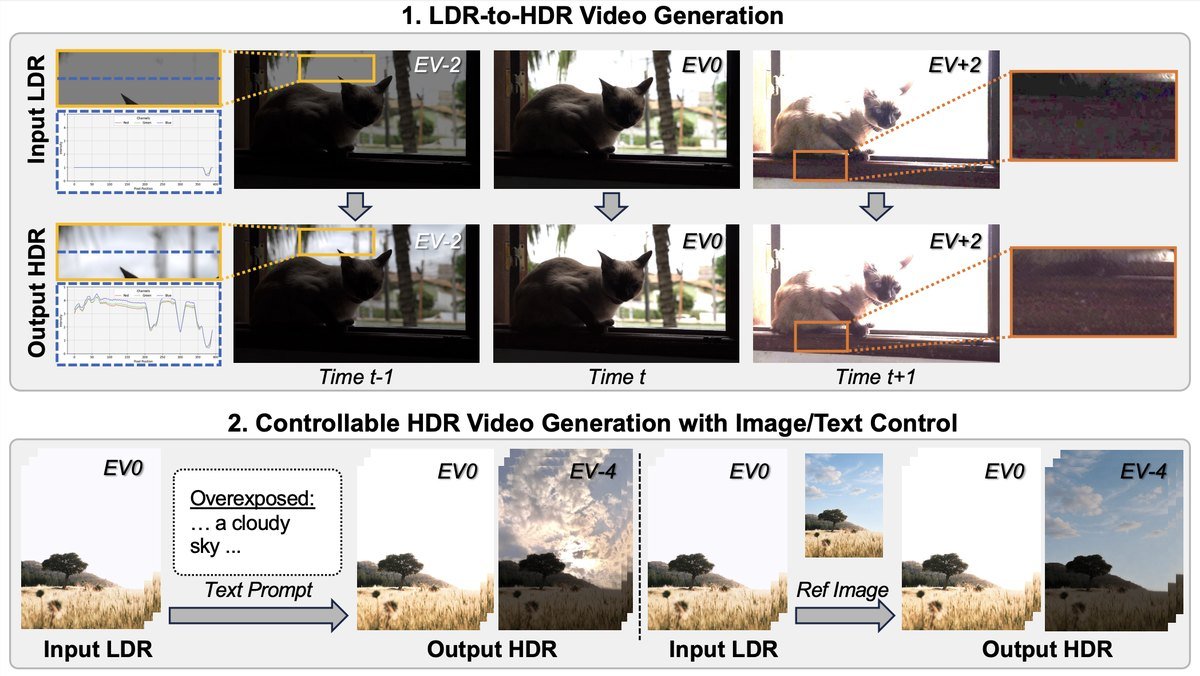
Um port de comunidade leva para o ComfyUI o DiffHDR, do Eyeline Labs com Netflix e Texas A&M (ECCV 2026). Entra vídeo LDR de 8 bits, sai HDR linear, com os estouros regenerados por Wan2.1-VACE-14B mais um LoRA. Grava EXR em Rec.709 linear a partir do quadro 1001, em qualquer duração, por janelas de 33 quadros com cross-fade. A saída é 1280×720, e o README manda fazer upscale e devolver sobre o plate original pela máscara de exposição. Numa RTX 5070 Ti de 16 GB são uns 5 minutos por janela, segundo o autor. O código do paper é de 30/06 e o LoRA de 21/09; novo é o port, de uma conta que eu não conheço, com 1 estrela. Não auditei nem testei.
Pra compConcorre com o HDR por IC-LoRA do LTX, com outra base e saída pronta para o Nuke. O limite é o de sempre: 720p e brilho de highlight que pode variar entre janelas, então meça o flicker nas emendas. Código de conta nova passa por auditoria antes de instalar.
Smart Guides: os nodes encaixam alinhados enquanto você arrasta
Extensão do nomadoor para o canvas do ComfyUI. Ao arrastar, o node encaixa onde o fio fica reto e nas bordas de outros nodes e grupos. Também alinha e distribui, iguala largura e altura, mostra alças de espaçamento e deixa redimensionar grupo pelos quatro cantos. Funciona no renderer clássico e no Nodes 2.0, tem licença MIT e já está no ComfyUI Manager.
Pra compNão muda render nenhum, muda o tempo de arrumar grafo. Para workflow que vai ser lido por outra pessoa, ou por você daqui a um mês, se paga no primeiro dia.
Imagem: NineCrowns, folha de comparação do repositório
14/11 · 15/11 atualizadohuggingface.coconferido na fonte
CROWN: LoRA que leva o vídeo do MiniMax-H3 a 3 ou 4 passos
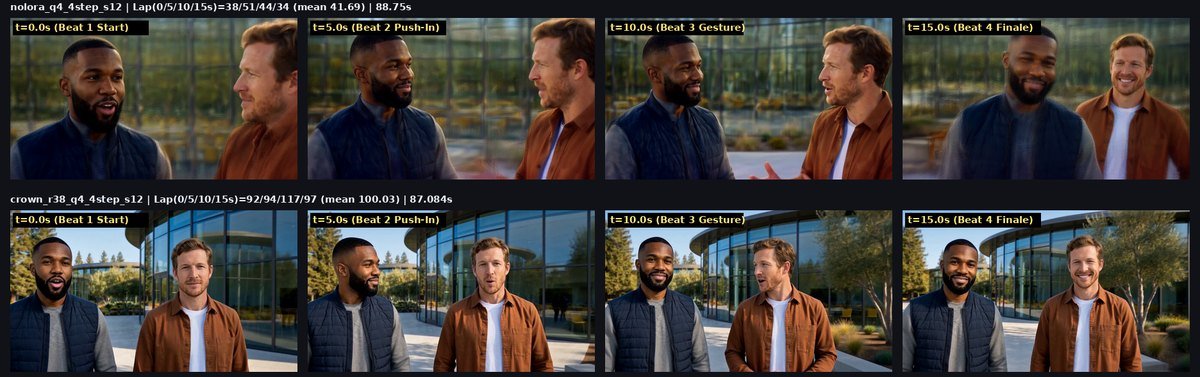
Dois LoRAs de destilação para o MiniMax-H3 de vídeo, um para texto, imagem e first-last, outro para vídeo por referência, com nove workflows de ComfyUI. A promessa do autor: 15 s (362 quadros a 24 fps, com áudio) em 3 ou 4 passos, CFG 1.0, euler, sobre BF16, int8 ou GGUF Q4_K_M, este com menos de 9 GiB de VRAM. A folha de comparação mostra 4 passos sem o LoRA, borrado, e com ele, nítido. Apache-2.0. Os números são do autor, que eu não conheço, e eu não testei.
Pra compSe segurar, é rascunho de movimento em minutos numa 3090, para escolher take antes do render cheio. Compare com o render de muitos passos no que pesa para matte: textura fina e estabilidade do que deveria ficar parado.
enviado 13/11 · público 16/11arxiv.orgconferido na fonte
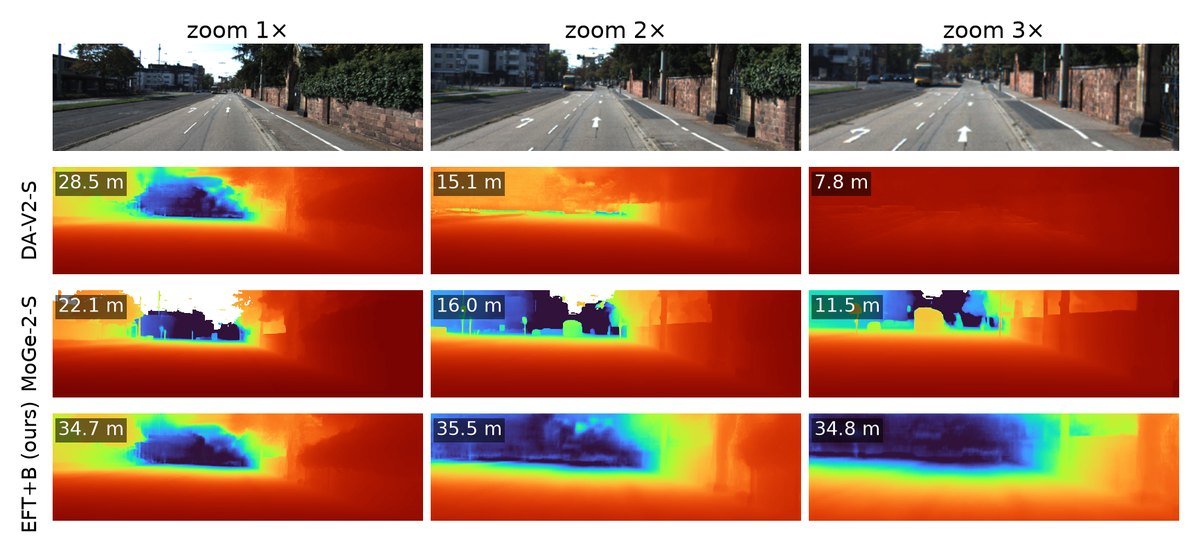
Zoom digital engana o depth métrico: o modelo acha que a câmera chegou perto
Recortar e ampliar uma foto não muda a distância das coisas, mas vários modelos de profundidade métrica respondem como se a câmera tivesse andado. Os autores medem isso com um índice α, em que 0 ignora o zoom e 1 trata o zoom como aproximação. O Depth Anything V2 dá 0,95. Os modelos que também estimam a câmera ficam entre 0,31 e 0,36. Com a câmera verdadeira informada, Depth Pro e DA3-Nested vão a perto de zero. A correção proposta, sem treino e sem rótulo, leva o Depth Pro a 0,04. Teste em 800 imagens (KITTI, NYUv2, DIODE), com controle de zoom óptico real. Código MIT.
Pra compTodo push-in feito por recorte em cima de um matte cai nesse caso: se o depth sair do quadro já ampliado, o Z encolhe junto com o zoom. Tire o depth da imagem inteira e recorte depois, ou informe a focal ao modelo.
enviado 13/11 · público 16/11arxiv.orgconferido na fonte
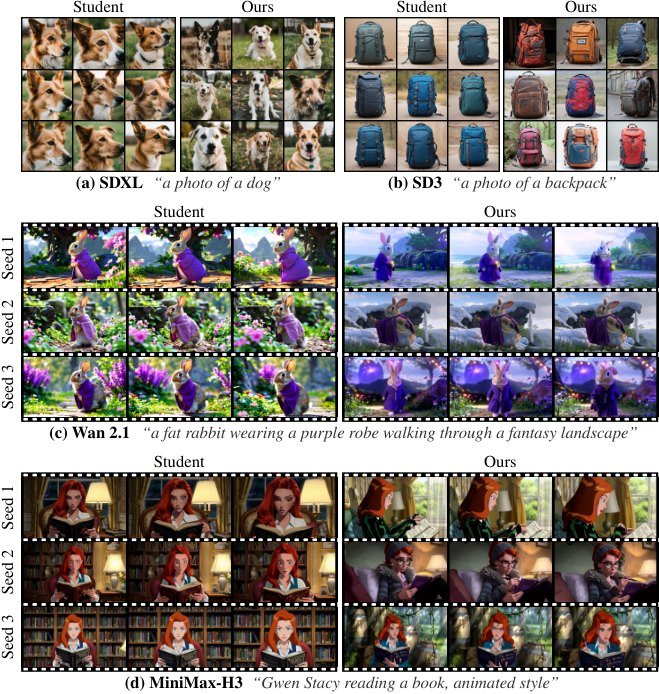
ReDiverse: devolve a variedade que a destilação tira das seeds
Modelo destilado para poucos passos tende a dar quase a mesma imagem ou o mesmo vídeo em qualquer seed. O paper localiza a causa: no primeiro passo de denoise, a variação das ativações se concentra em poucas direções de um bloco intermediário. Daí saem duas correções, um adaptador leve (ReDiverse-FT) e uma versão sem treino que empurra as ativações nas direções do modelo professor (ReDiverse-TF). A figura de abertura mostra SDXL, SD3, Wan 2.1 e MiniMax-H3. Código Apache-2.0; os pesos no Hugging Face pedem aceite e têm licença própria.
Pra compÉ o defeito de todo LoRA de 4 passos: você troca a seed e o take volta igual. Se a versão sem treino virar node, dá para manter a velocidade e voltar a ter opções de movimento para escolher. Por enquanto é paper e código, sem node.
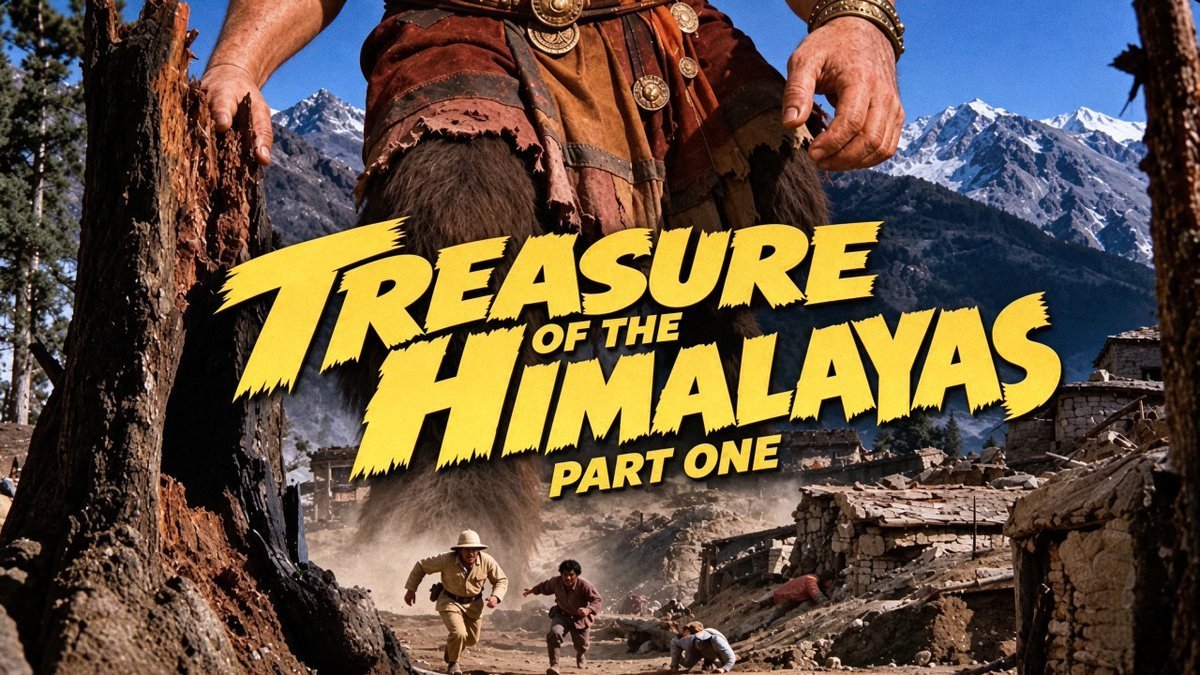
Imagem: Chris Gwinn e Peter Hyoguchi, quadro do filme
15/11x.comconferido na fonte
Treasure of the Himalayas: 8 minutos e meio de aventura em Technicolor
Chris Gwinn e Peter Hyoguchi soltaram a primeira parte, de 8,5 minutos, de um longa de aventura e ficção científica no estilo dos anos 1960. Os dois produzem e procuram investidor para terminar o longa em 2027. Eles apresentam a obra como filme de IA e declaram as ferramentas: Midjourney e Seedance 2.5, na Dreamina. O post não diz o que foi feito fora da IA nem dá crédito de montagem, som ou acabamento. Passou de 600 curtidas no X.
Pra compO look de época faz parte do truque: grão, halo e cor saturada disfarçam a textura de vídeo gerado. Repare em quanto tempo dura cada plano e onde a consistência de personagem cede de um corte para o outro.
13/11 original · 16/11 em 4Kyoutube.comconferido na fonte
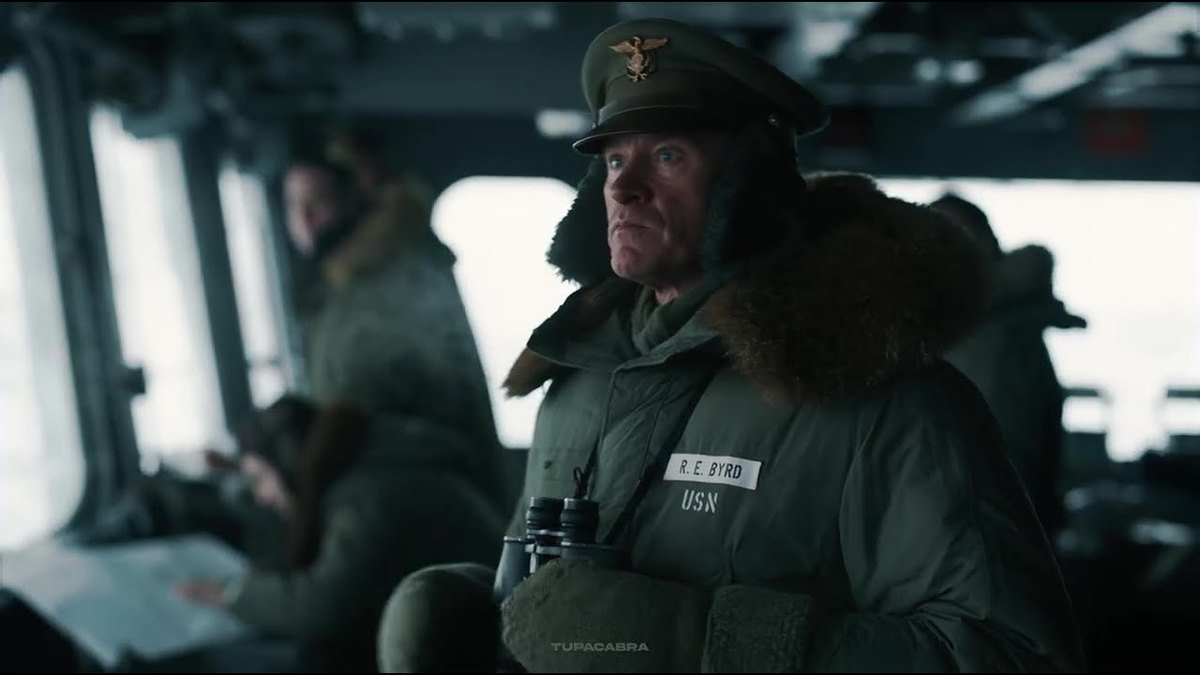
NUREMBERG 1561: o trailer que rodou o X volta em 4K
O trailer de TUPACABRA saiu no X em 13/11 e voltou em 16/11 em 4K, no X e no YouTube (87 s), com mais de 1.400 curtidas no post novo. O autor declara que fez com a Venice. Segundo uma resposta no fio, as cenas em 4K foram geradas de novo e diferem um pouco das originais. A crítica que mais circulou, de 14/11, com 530 curtidas, lista o que falta: quase tudo é image-to-video, sem diálogo, com planos de 1 a 2 segundos e nenhum personagem que se repita. Li os posts e a ficha do vídeo; não assisti ao trailer.
Pra compBom retrato do teto do formato trailer: imagem forte, plano curto, nada que precise durar. Compare a versão original com a 4K para ver o que muda quando se gera de novo em vez de fazer upscale.
filme 06/11 · making of 16/11youtube.comconferido na fonte
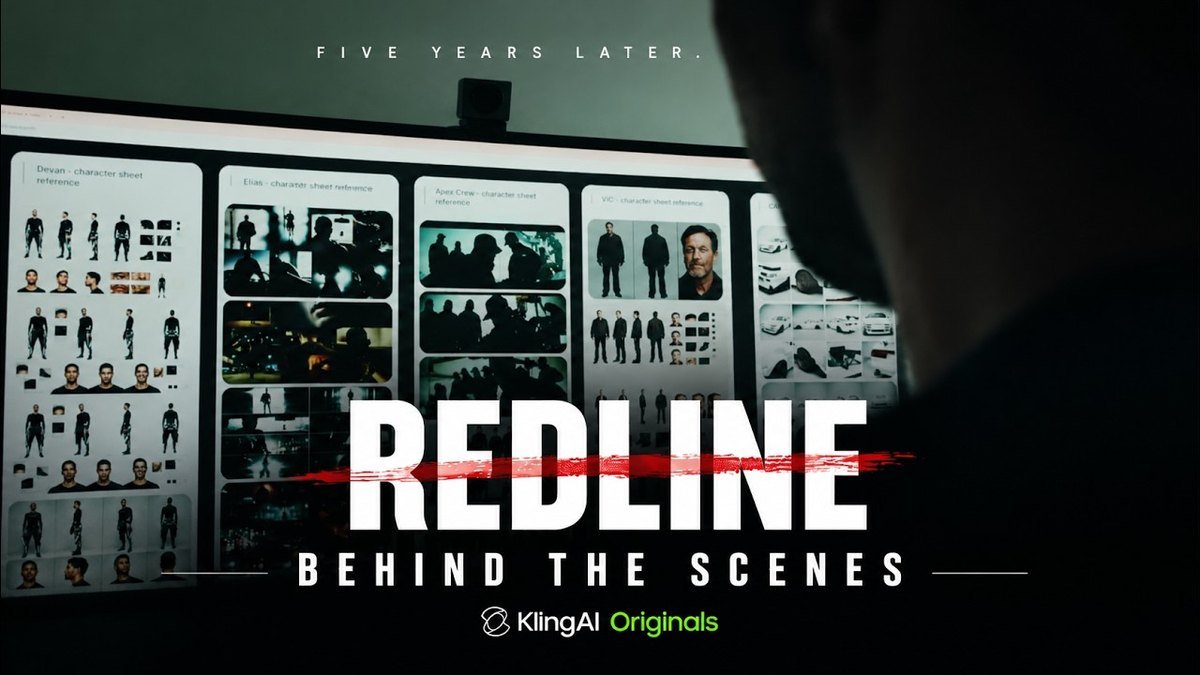
Redline: a Kling abre os bastidores do curta de 11 minutos
O curta saiu em 06/11, antes desta janela: 11 min 34 s, escrito e dirigido por Stephane Benini, com montagem de Yves Dalbiez, produção de Rodrigo Orozco, pós e VFX de Bruno Detante, som e música da un.studios, apresentado como feito com o Kling 4.0. Desta janela é o making of de 2 min 42 s, publicado pela Kling, com a parede de fichas de personagem usada na produção. É marketing da própria plataforma. O filme passou de 140 mil visualizações.
Pra compHá crédito de pós e VFX separado, sinal de acabamento fora do gerador. No making of, repare na quantidade de fichas de personagem: a consistência vem de preparo, não só do modelo.
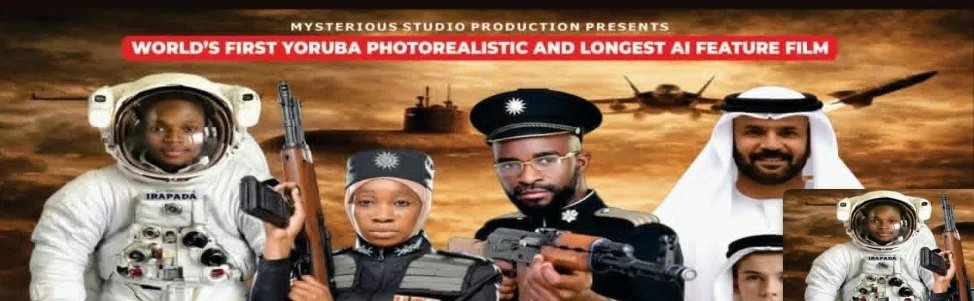
Asiri Ilu Awon Osu: longa iorubá de IA vai para a TV dos EUA
O Mysterious Tech Studios, da Nigéria, levou o longa (Mystery of Osu Land) para a AfrolandTV, plataforma de streaming dos Estados Unidos, e baixou o preço na Docuth depois de problemas de acesso na estreia, segundo o Punch. O estúdio diz que as duas partes são 80% geradas por IA e 20% filmadas, com 72 cenas de IA e 16 com atores, e contesta quem afirma que só 30% é IA. O pedido de recorde ao Guinness não foi certificado e não há número de vendas. A matéria não diz quais ferramentas.
Pra compA conta de cenas é o dado útil: filmado e gerado no mesmo longa, numa língua que os modelos mal cobrem. Não achei link oficial para assistir, então não dá para julgar a emenda entre as duas partes.
Matteo AI Studio: de 3 para 20 pessoas e um longa no cinema
Três diretores coreanos, Jung Joo-won, Moon Shin-woo e Yang Ik-jun, fizeram em 2024 o curta Matteo, de 16 minutos, gastando cerca de 4 milhões de wons em ferramentas. Dois anos depois o estúdio tem 20 funcionários, investimento de empresa e o longa Raphael, dirigido por Jung, com estreia marcada no Lotte Cinema para o dia 25 e contrato de segunda janela com a KT Studio Genie. O roteiro foi escrito pela equipe e os personagens passaram por várias revisões no Photoshop antes do registro de direito autoral.
Na mesma matéria, a CJ 4DPLEX conta que passou a usar IA generativa, junto com VFX tradicional, para produzir as paredes laterais do ScreenX. A versão ScreenX de um filme de Hollywood leva cerca de quatro semanas. O texto da Aju Press é tradução automática: as ferramentas aparecem como “Bio”, do Google, e “Sidance”, da BytePlus, provavelmente Veo e Seedance. A fonte não tem imagem.
Pra compDois recados. Estúdio pequeno vira empresa para pegar edital e serviço terceirizado, com personagem e mundo próprios como ativo. E as laterais do ScreenX são extensão de quadro em escala de longa: outpaint de vídeo com continuidade, o mesmo problema de ampliar uma placa para caber a câmera.
Imagem: Manchester Animation Festival, via Cartoon Brew
13/11 à noitecartoonbrew.comconferido na fonte
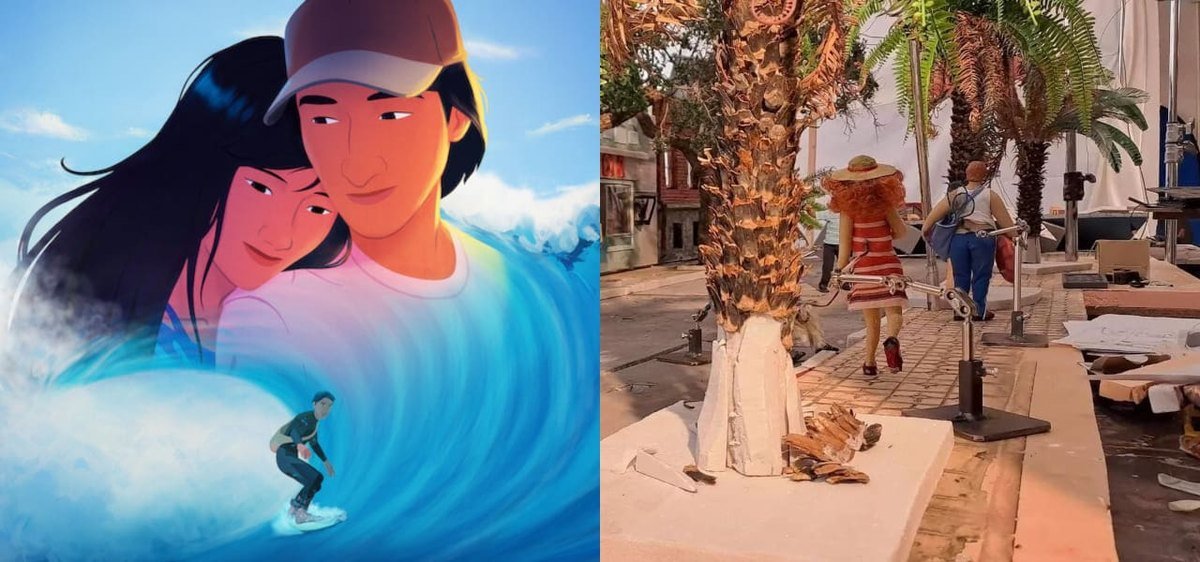
Festival de animação de Manchester barra IA generativa a partir de 2027
O Manchester Animation Festival anunciou, junto com os premiados de 2026, que não aceita mais filme com IA generativa a partir das inscrições de 2027. O diretor Steve Henderson disse que a nova política põe os artistas em primeiro lugar. A matéria do Cartoon Brew não traz a definição do que conta como IA generativa, e eu não vi o texto da política. O anúncio é de sexta, 13/11, à noite, depois do fechamento da edição 01, por isso entra aqui. Melhor longa: In Waves, de Phuong Mai Nguyen.
Pra compSegundo festival em duas semanas a fechar a porta, depois do Camerimage na edição 01. Sem definição publicada, não dá para saber se limpeza, upscale e roto por IA entram no veto: quem inscreve curta com qualquer passo de IA precisa perguntar antes.
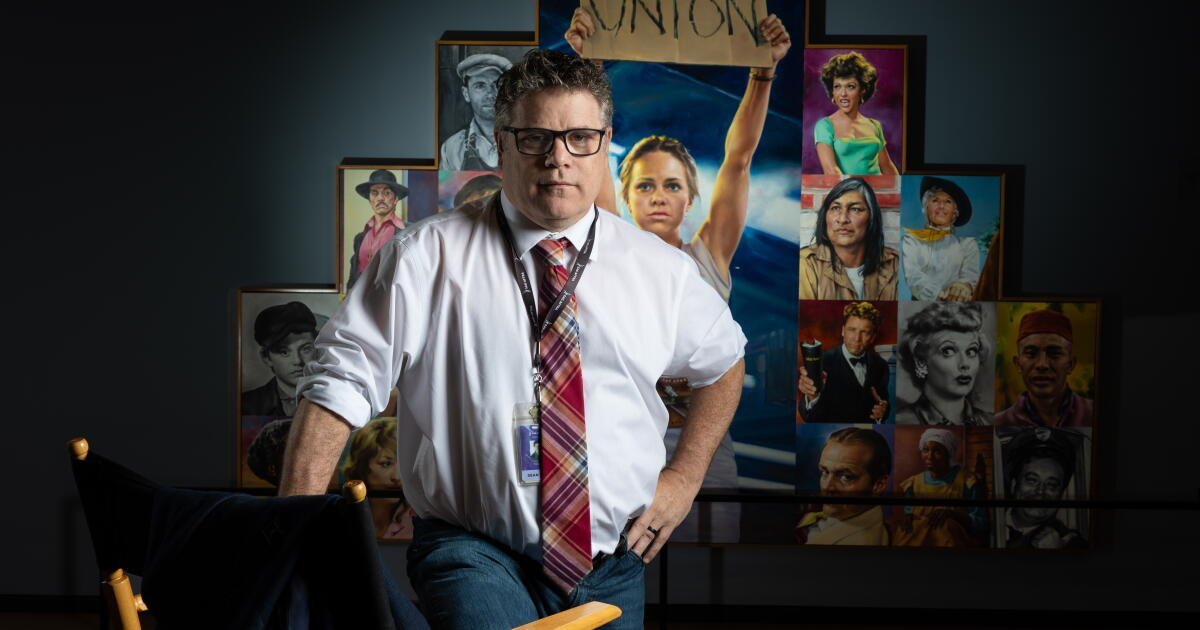
Perfil do Los Angeles Times no primeiro ano de Astin na presidência do sindicato de atores, que tem cerca de 160 mil membros. O contrato ratificado em junho obriga o produtor a avisar o sindicato quando usar personagem sintético num papel que uma pessoa poderia fazer. Sobre barrar a IA de vez, ele diz que nenhuma empresa aceitaria ficar em desvantagem e resume o resultado: conseguiram o que deu, e desaceleraram. Cobra a votação do No Fakes Act e diz que o governo federal foi péssimo no assunto. É outra notícia, não a do SAG-AFTRA da edição 01.
Pra compA regra que chega ao set é de aviso, não de proibição. Em dublê digital, multidão e personagem gerado, a pergunta da produção passa a ser se o sindicato foi notificado, e isso pode entrar no cronograma do plano.
14/11 evento · 16/11 matériachina.org.cnconferido na fonte
China: aliança de ficção científica com IA estreia com quatro adaptações
Lançada em Chengdu, durante a Nebulacon, diante de mais de 300 escritores e roteiristas. Os fundadores são a Hainan Eternal Vision (EV/SFM), dona dos direitos de 81 obras de ficção científica, a Beijing Flying Youth Culture Media e a Perfect World Pictures, que entra com ferramentas de IA e investimento para baixar o custo de efeitos, apontado como a barreira do gênero. As quatro primeiras adaptações são de livros de He Xi, Jiang Bo, Cheng Jingbo e Xiao Xinghan, e o plano inclui série, animação e games. A fonte é mídia estatal chinesa.
Pra compÉ catálogo de IP amarrado a pipeline de IA desde o contrato: o efeito pesado, que era o motivo de não filmar, vira a premissa. O anúncio não cita nenhum estúdio de VFX.
Quatro hipóteses que saem desta edição. Nenhuma foi testada.
Video Deflicker depois de um upscale quadro a quadro de placa viva, com o plate original de guia: o pisca some sem arrastar fogo e folha?
Workflow de 16 GB do H3-Image numa 3090: 16 MP em quanto tempo, com quanta RAM, e o decode normal sai sem costura?
DiffHDR em 720p, upscale e volta sobre o plate pela máscara de exposição, contra o HDR por IC-LoRA do LTX: qual segura melhor o highlight de uma janela para a outra?
Depth de um push-in feito por recorte: tirar o Z do quadro cheio e recortar, contra tirar do quadro já ampliado. O paper diz que o segundo encolhe a cena.
Buracos desta edição
Janela curta: três dias, dois de fim de semana. Por isso 18 itens, e Gente com um só, sem imagem.
Sem release do ComfyUI na janela: o último é a v0.45.0, de 10/11. Video Deflicker e PAN 2 estão só no master.
O arXiv não teve envio datado de 14 a 16/11. Os dois papers são de 13/11 e ficaram públicos em 16/11.
O Instagram pediu login na segunda página e eu parei ali. O Reddit não abriu no navegador. As redes desta edição são YouTube e X.
Ficaram de fora por falta de conferência: um comercial com Frida Kahlo feito por IA (a matéria não abriu) e o curta The First Honest Day (o site bloqueou).
Nenhuma obra brasileira apareceu na janela. Os feeds da AWN, da LBB e do Meio & Mensagem não responderam.
O Banodoco não trouxe novidade na janela.
ST-ROTO, roto com SAM 2.1 dentro do Nuke, apareceu em 15/11 só com README: o próprio autor diz que ainda não há código.
Das quatro coletas automáticas, uma voltou sem lista e outra não terminou.